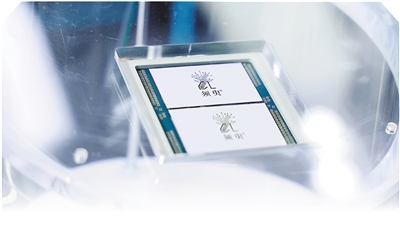
中昊芯英新一代高性能TPU AI专用算力芯片“须臾”。
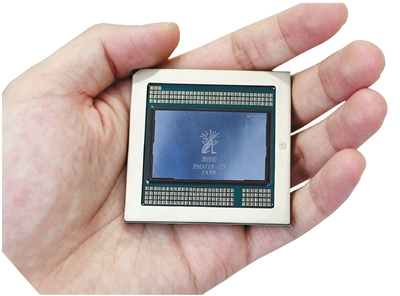
中国首枚高性能TPU AI专用算力芯片“刹那”。 企业供图
见习记者 毛欣欣
算力,是人工智能产业发展的动力底座。随着大模型、AI智能体的爆发式发展,一个痛点愈发突出:用户输入一条简短指令,但背后却要调取几十万甚至上百万字历史对话,数据读取量远大于内容生成量。
传统GPU芯片的一套单元既要读取海量历史资料,又要生成回答,多项任务争抢资源,很容易出现回复卡顿、算力浪费等问题,这也是不少智能体业务持续亏损的重要原因。AI普惠成为大数据时代一个绕不开的难题。
在2026世界人工智能大会上,中昊芯英(杭州)科技股份有限公司(以下简称“中昊芯英”)自研的新一代TPU架构AI芯片“须臾”首次亮相,精准解决了传统算力芯片存在的访存延迟、能耗偏高、并行效率不足等痛点。
“须臾”,其核心含义是极短的时间或片刻。
与此同时,由中昊芯英联合杭州电信、中兴通讯共建的华东地区(杭州)首个国产TPU千卡智算集群正式亮相,被业内视为国产算力从实验室迈向大规模商用的标志性一步。
作为国内最早一批TPU探索企业,中昊芯英也是国内目前唯一实现全自研高性能TPU架构AI专用算力芯片量产交付的企业。在杭州,中昊芯英正从一枚小小的算力芯片出发,探索国产算力的破局之路。
从“刹那”到“须臾”
给AI装上损耗更低的“动力心脏”
TPU(TensorProcessing Unit,张量处理器),是一种专门用于加速人工智能和机器学习任务的芯片,从设计之初,就专为大模型深度学习打造。
而大众更为熟知的GPU(Graphics Processing Unit,图形处理器),则主要用于渲染3D图形,凭借强大的并行计算能力,被广泛应用于AI领域。
2018年,在Transformer大模型架构显现巨大潜力之时,身为谷歌TPU核心研发团队的华人工程师杨龚轶凡,见证了Transformer架构在TPU上的强大适配性,他预判大模型时代终将到来,TPU相比GPU更适配大模型算力需求。
彼时,国内缺少自研TPU路线算力芯片的团队,算力自主可控存在短板,于是,他下定决心回国。
2020年,杨龚轶凡创立的中昊芯英正式落地杭州。当时,国内不少芯片公司都跻身GPU赛道,立志打造“中国版英伟达”,而他却认为,当某类计算需求体量足够庞大,就会激发相应的专用芯片需求,面向大模型的TPU专用芯片,将会是AI时代的重要答案。
基于这一判断,中昊芯英另辟蹊径,选择深耕TPU赛道,希望推动TPU成为AI领域通用底层架构,对标CPU领域X86架构,打造全行业通用AI计算标准。
2023年,中昊芯英推出国内首款高性能TPU AI专用算力芯片“刹那”,在AI大模型计算场景中,其算力性能超越海外著名GPU产品近1.5倍,能耗降低30%。
同时,它还实现了1024片芯片片间互联,能够支撑超千亿参数大模型运算需求。
在初代芯片“刹那”商业化落地的三年里,研发团队依据收集到的客户真实反馈,持续优化,推出了实现三倍性能提升的二代芯片“须臾”。
相比于“刹那”,“须臾”的升级主要有三大方面:一是重构整套计算流水线与张量逻辑,单芯片混合精度算力达到上代“刹那”的3倍;二是存储体系全面升级,缓解大模型反复读写带来的“存储墙”瓶颈;三是互联通信能力升级,单超节点最高可实现2048片芯片直接全光互联,集群性能近乎线性增长。
“两代芯片的核心目标都是输出AI算力。为了在同等成本条件下输出更高算力,每一代芯片迭代的方向之一都是降低功耗。”中昊芯英CMO黄绪进一步介绍,除了平衡性能和芯片面积,基于“须臾”打造的“泰则”整机架构,同样迎来创新——单台设备搭载16颗“须臾”计算芯粒,在不增加配套CPU的情况,便能拥有32个计算芯粒。在芯片算力规模翻倍的前提下,不额外增加昂贵主机配套硬件投入,从整机系统层面直接降低算力采购成本。
让AI真正普惠大众
千卡智算集群赋能千行百业
单颗芯片性能再强,也只是独立的零件。只有把大量芯片有序组建成智算集群,稳定运行,算力的价值才能真正释放。
上千颗芯片组网,远不是简单把硬件堆在一起。芯片数量变多之后,芯片之间通信会消耗大量算力,设备故障概率上升,机房散热、能耗配额也都会成为现实考验。
华东地区(杭州)首个国产TPU千卡智算集群,正是这套工程能力的集中体现。基于“泰则”人工智能服务器与计算集群系统构建,通过分布式调度与故障检测体系,中昊芯英实现了集群的节点级隔离,配套全链路状态监控、故障预警与远程管控,保障大规模集群稳定运行。
值得一提的是,这并不是中昊芯英参与建设的第一个智算中心,此前还在深圳联通、天津移动等运营商,浙江大学、上海交通大学等高校,以及各地政府主导建设的智算中心中实现成熟落地。“选择在杭州建设千卡集群,既能补齐华东区域的算力布局,也能充分依托和联动本地丰富的AI企业、互联网企业资源。”黄绪说。
华东地区(杭州)首个国产TPU千卡智算集群遵循“芯片底座—运营商算力平台—行业客户”的产业层级:芯片企业输出底层算力,运营商搭建MaaS业务平台,再面向千行百业输出服务。杭州电信依托该集群,打造“Token工厂”,为本地互联网企业、政企单位提供高性价比算力;天津移动智算中心同样采用中昊芯英TPU算力底座,支撑起政务、医疗、教育、工业等多元场景的大模型业务……
虽然普通老百姓不会直接接触机房与芯片,但是算力的红利会间接影响到大家日常生产生活的方方面面。有了平价的国产算力,中小企业不用承担高昂的海外算力开支,也能开发属于自己的AI应用。长远来看,算力成本下降,也能帮助更多AI产品维持亲民的定价,让AI真正普惠大众。
芯片研发是一场长跑,一颗芯片从图纸设计走向商用落地普遍需要四到五年,前期投入巨大。硬件实现自主只是第一步,软件生态同样是国产芯片从“能用”走向“好用”的关键。
中昊芯英扎根杭州,是因为这里有完善的数字经济产业土壤、贴心的地方政策,以及国有及民营资本的大力支持。未来,企业将持续深耕AI专用算力芯片领域,向着更大规模集群互联技术发起攻关,同时,持续推进芯片与模型厂商深度“芯模联动”和调优,进一步打通芯片、服务器集群到行业落地的全链路,用自主可控、高性价比的国产算力,为数字经济发展注入源源不断的“芯”动力,在全球AI算力赛道擦亮中国智造的名片。